TP2e année8 livrables
Disponibilité & supervision
Déployer un service, c'est bien. Garantir qu'il reste en ligne et être prévenu avant les utilisateurs quand il tombe, c'est le métier. La supervision, c'est mettre des yeux sur ton service : mesurer sa disponibilité, surveiller sa santé, déclencher des alertes. Aujourd'hui tu rends AppliFrais observable et tu apprends à le maintenir en condition opérationnelle.
Par Josselyn C., prof de BTS SIO. Publié le .
- Objectif
- assurer et surveiller la disponibilité d'AppliFrais (health checks, monitoring, alertes, métriques)
- On manipule
- un health check, un moniteur d'uptime, des métriques, des alertes
- Pré-requis
- AppliFrais déployé (VPS/PaaS ou Docker)
- Pour qui
- SLAM, 2e année
- Durée
- 1 séance
Compétences : C1.5 Mettre à disposition des utilisateurs un service informatique, C1.2 Répondre aux incidents et aux demandes d'assistance et d'évolution
« Vérifier la disponibilité et la performance d'un service » est une compétence explicite du Bloc 1.
Avant de commencer
Pourquoi cette séance
Un service déployé n'est pas un service fiable. Il peut tomber (crash, panne serveur, base saturée), ralentir, ou se remplir d'erreurs — et si personne ne regarde, tu l'apprends par un utilisateur mécontent, des heures trop tard. La supervision (monitoring) consiste à observer ton service en continu : est-il disponible ? rapide ? en bonne santé ? Et à alerter automatiquement dès qu'un seuil est franchi. C'est une compétence explicite du Bloc 1 (« vérifier la disponibilité et la performance ») et un marqueur de professionnalisme : un dev junior livre une appli ; un pro la livre observable. Aujourd'hui tu instrumentes AppliFrais.
Ce que tu vas apprendre
| Concept | Ce que tu sauras faire |
|---|---|
| Disponibilité (uptime) | définir et mesurer le taux de disponibilité |
| Health check | exposer un endpoint de santé |
| Monitoring d'uptime | surveiller que le service répond, de l'extérieur |
| Métriques | mesurer performance et erreurs (Prometheus/Grafana) |
| Alertes | être prévenu avant les utilisateurs |
Le décor : AppliFrais
On travaille sur GSB AppliFrais, ton API de notes de frais : un serveur Express qui écoute sur le port 3000, branché à une base MongoDB, déployé (sur un VPS, un PaaS, ou en Docker). Les visiteurs saisissent leurs frais, les comptables les valident. Si l'API tombe en fin de mois, personne ne saisit ses frais : c'est un service qui doit rester debout. Tout au long de la séance, les exemples pointent vers cette appli.
0. La disponibilité, ça se mesure
La disponibilité (uptime) est le pourcentage de temps où le service répond correctement. On l'exprime en « neufs ».
| Uptime | Indisponibilité / an | Niveau |
|---|---|---|
| 99 % | ~ 3,65 jours | faible (amateur) |
| 99,9 % (« trois neufs ») | ~ 8,8 heures | correct (PME) |
| 99,99 % | ~ 52 minutes | élevé (service critique) |
| 99,999 % | ~ 5 minutes | très élevé (banque, télécom) |
Les trois indicateurs de reprise
Quand le service tombe, deux autres métriques entrent en jeu : combien de temps pour le remettre debout, et combien de données sont perdues.
| Sigle | Définition | Valeur cible typique | Qui la choisit |
|---|---|---|---|
| MTTR — Mean Time To Repair | temps moyen entre le début d'une panne et sa résolution | 5-30 min (prod web) | équipe ops |
| RTO — Recovery Time Objective | durée max tolérée avant reprise de service après un sinistre | 15 min (PME) / 4 h (startup) | direction / client |
| RPO — Recovery Point Objective | volume max de données qu'on peut se permettre de perdre | 0 à 24 h selon criticité | direction / DPO |
Comment on la calcule
L'uptime n'est pas une opinion : c'est un calcul. Sur une période donnée, le moniteur additionne le temps où le service répondait (temps up) et le temps où il ne répondait pas (temps down), puis :
uptime % = (temps_up / temps_total) * 100

# exemple sur 30 jours = 43200 minutes
# le service a ete down 30 minutes
# uptime = (43200 - 30) / 43200 * 100 = 99.93 %
Flag A1
Checkpoint
(a) Calcule l'indisponibilité annuelle tolérée pour un objectif de 99,9 %. (b) Quel niveau d'uptime te semble raisonnable pour AppliFrais, et pourquoi (besoin métier) ? Rends : ton calcul + ton objectif justifié.
1. Le health check
C'est quoi un endpoint de santé ?
Comment savoir, de l'extérieur, si AppliFrais va bien ? On expose un endpoint de santé (health check) : une URL dédiée, par convention /health, qu'on peut interroger à tout moment. Elle ne sert pas l'utilisateur ; elle sert les outils de surveillance. C'est le « pouls » de ton service : un médecin ne te demande pas si tu vas bien, il prend ton pouls. Pareil ici : on ne demande pas, on mesure.
Étape 1 — la version naïve (à ne pas garder)
Premier réflexe d'un débutant : une route qui répond juste « je suis là ».
// AppliFrais - app.js (Express ecoute sur le port 3000)
// VERSION NAIVE : ne teste rien, ment facilement
app.get('/health', (req, res) => {
  res.json({ status: 'ok' });   // repond toujours ok, meme si la base est morte
});
Étape 2 — tester les dépendances critiques
Un vrai health check vérifie que les dépendances dont dépend le service (ici : la base) répondent. On « pingue » MongoDB : une commande minuscule qui répond instantanément si la base est joignable, et lève une erreur sinon.
// AppliFrais - app.js
// VERSION COMPLETE : teste l'API ET la base
const mongoose = require('mongoose');

app.get('/health', async (req, res) => {
  try {
    // ping = commande admin la plus legere : "es-tu la ?"
    await mongoose.connection.db.admin().ping();
    res.json({ status: 'ok', uptime: process.uptime() });
  } catch (e) {
    // la base n'a pas repondu : on signale un service degrade
    res.status(503).json({ status: 'degraded', db: 'down' });
  }
});
Étape 2 bis — version multi-dépendances (pattern pro)
En production, une API a souvent plusieurs dépendances critiques (base de données, cache Redis, service externe…). Le pattern pro : vérifier chacune avec un timeout court, et renvoyer un rapport structuré.
// AppliFrais - app.js
// VERSION MULTI-DEPS : un rapport par dependance, timeout 800 ms

const mongoose = require('mongoose');

async function checkMongo() {
  // timeout de 800 ms : un health check doit repondre en < 1 s
  const timeoutPromise = new Promise((_, reject) =>
    setTimeout(() => reject(new Error('timeout')), 800)
  );
  await Promise.race([
    mongoose.connection.db.admin().ping(),
    timeoutPromise
  ]);
}

app.get('/health', async (req, res) => {
  const checks = {};
  let globalStatus = 'ok';

  try {
    await checkMongo();
    checks.mongo = { status: 'ok' };
  } catch (e) {
    checks.mongo = { status: 'down', error: e.message };
    globalStatus = 'degraded';
  }

  const statusCode = globalStatus === 'ok' ? 200 : 503;
  res.status(statusCode).json({
    status: globalStatus,
    uptime: Math.floor(process.uptime()),
    timestamp: new Date().toISOString(),
    checks                             // rapport par dependance
  });
});
# service sain
HTTP/1.1 200 OK
{"status":"ok","uptime":86412,"timestamp":"2026-01-14T09:22:01Z",
 "checks":{"mongo":{"status":"ok"}}}

# Mongo down (timeout 800 ms declenche)
HTTP/1.1 503 Service Unavailable
{"status":"degraded","uptime":86412,"timestamp":"2026-01-14T09:22:01Z",
 "checks":{"mongo":{"status":"down","error":"timeout"}}}
Étape 3 — vérifier avec curl
curl est un outil en ligne de commande qui envoie une requête HTTP et affiche la réponse. -i ajoute la ligne de statut HTTP (le code 200/503) en tête.
curl -i https://appli-frais.fr/health
# --- service sain (base joignable) ---
HTTP/1.1 200 OK
Content-Type: application/json
{"status":"ok","uptime":86400}        # en vie depuis 86400 s = 1 jour

# --- service degrade (on a coupe MongoDB) ---
HTTP/1.1 503 Service Unavailable
Content-Type: application/json
{"status":"degraded","db":"down"}     # detecte immediatement
Flag B1
Production (health check)
Ajoute à AppliFrais une route /health qui vérifie l'API et la base (ping Mongo), et renvoie 503 si la base est injoignable. Rends : le code + la sortie de /health en état sain + (si possible) en état dégradé.
Flag C1
Debug (le health check qui ment)
Un collègue a livré ce /health. Il renvoie 200 même quand MongoDB est coupé : il ne teste pas la base.
// BUG : ne teste pas la base
app.get('/health', (req, res) => {
  res.status(200).json({ status: 'ok' });
});
Corrige-le pour qu'il pingue réellement la base et renvoie 503 si elle ne répond pas. Démontre la correction : arrête MongoDB, appelle /health, et rends : le code corrigé + la sortie 503 obtenue base coupée (capture curl -i).
2. Surveiller l'uptime de l'extérieur
Un service ne peut pas se surveiller lui-même : s'il est mort, il ne t'alerte pas. La supervision se fait de l'extérieur : un outil interroge ton /health toutes les minutes depuis ailleurs.
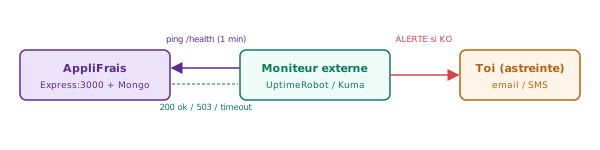
Le moniteur vit ailleurs que le serveur : si AppliFrais tombe, lui reste debout et t'alerte.
| Outil | Type / Hébergement | Intervalle min. | Gratuit | Alertes | Choisir si… |
|---|---|---|---|---|---|
| UptimeRobot | cloud (SaaS) | 1 min (payant) / 5 min (gratuit) | 50 moniteurs, 1 canal | email, SMS (payant), webhook | démarrer vite, pas de serveur à gérer |
| BetterStack Uptime | cloud (SaaS) | 30 s (payant) / 3 min (gratuit) | 10 moniteurs, 1 canal | email, appel téléphonique, Slack | besoin de logs intégrés (BetterStack propose aussi de l'agrégation de logs) |
| Uptime Kuma | auto-hébergé (Docker) | 20 s | 100 % gratuit, moniteurs illimités | email, Telegram, Discord, webhook, Gotify… | pas d'URL publique, données internes, RGPD strict |
| Healthchecks.io | cloud (SaaS) | N/A (mode push : le cron ping le moniteur) | 20 tâches, 1 projet | email, Slack, PagerDuty | surveiller des tâches planifiées (cron) qui doivent s'exécuter à heure fixe |
Mise en place pas à pas (UptimeRobot)
Exemple avec un service hébergé gratuit. La logique est la même partout.
- Crée un compte sur le service de monitoring.
- « Add New Monitor » → type HTTP(s).
- URL :
https://appli-frais.fr/health(le vrai health check, pas la home). - Interval : 1 minute (la plus fréquente possible).
- Alert contact : ton email (et/ou un webhook vers Discord/Slack).
- Option utile : « treat 503 as down » — pour qu'un service dégradé déclenche aussi l'alerte, pas seulement un service injoignable.
Le moniteur appelle alors ton endpoint chaque minute et tient un journal :
Monitor: AppliFrais /health    interval: 60s
14:02  UP    200   123 ms
14:03  UP    200   118 ms
14:04  DOWN  503   --        # base coupee -> ALERTE envoyee a 14:04
14:05  DOWN  ---   timeout   # app arretee
14:09  UP    200   130 ms    # remise en route -> notif "back up"
Uptime (30 j): 99.93 %        # la mesure objective de ta dispo
Flag B2
Production (monitoring)
Mets en place un monitoring d'uptime externe (UptimeRobot/Uptime Kuma) sur le /health d'AppliFrais, avec une alerte. Simule une panne (arrête l'app) pour vérifier l'alerte. Rends : la config du moniteur + la preuve de l'alerte déclenchée + ton uptime %.
3. Métriques : au-delà du « up/down »
Savoir que le service est « up » ne suffit pas : un service peut répondre tout en étant lent ou en crachant des erreurs. Les métriques mesurent ces dimensions fines. On surveille en priorité quatre signaux dorés :
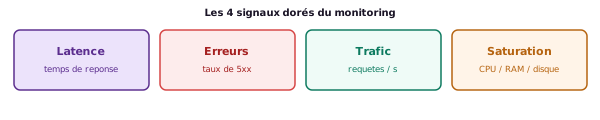
| Métrique | Ce qu'elle révèle |
|---|---|
| Temps de réponse (latence) | le service ralentit-il ? |
| Taux d'erreurs (5xx) | combien de requêtes échouent ? |
| Trafic (req/s) | la charge augmente-t-elle ? |
| Ressources (CPU, RAM, disque) | le serveur sature-t-il ? |
Exposer un endpoint /metrics
Prometheus ne devine rien : il vient lire, à intervalle régulier, une page /metrics que ton app publie. La librairie prom-client fait le gros du travail.
// AppliFrais - app.js
const client = require('prom-client');
client.collectDefaultMetrics();   // CPU, RAM, event loop... automatiquement

app.get('/metrics', async (req, res) => {
  res.set('Content-Type', client.register.contentType);
  res.end(await client.register.metrics());   // texte lisible par Prometheus
});
curl http://localhost:3000/metrics
# HELP process_cpu_seconds_total Total user and system CPU time
process_cpu_seconds_total 12.4
# HELP nodejs_heap_size_used_bytes Process heap used
nodejs_heap_size_used_bytes 38502400
# HELP http_request_duration_seconds Request latency
http_request_duration_seconds_bucket{le="0.1"} 842   # 842 reqs sous 100 ms
Métriques custom — compter ce qui compte pour le métier
Les métriques système (CPU, RAM) sont utiles, mais les métriques métier le sont encore plus : combien de notes de frais sont soumises par heure ? Combien de rejets de connexion ? prom-client permet d'ajouter tes propres compteurs en 3 lignes.
// AppliFrais - app.js (ajouter apres collectDefaultMetrics)
const client = require('prom-client');

// compteur : s'incremente, ne redescend jamais
const fraisSubmits = new client.Counter({
  name: 'gsb_frais_submits_total',
  help: 'Nombre de fiches de frais soumises depuis le demarrage',
  labelNames: ['statut']   // 'ok' ou 'erreur'
});

// exemple d'utilisation dans la route POST /frais
app.post('/frais', async (req, res) => {
  try {
    const fiche = await Fiche.create(req.body);
    fraisSubmits.inc({ statut: 'ok' });     // +1 succes
    res.status(201).json(fiche);
  } catch (e) {
    fraisSubmits.inc({ statut: 'erreur' }); // +1 echec
    res.status(500).json({ error: e.message });
  }
});
# ce que Prometheus lit sur /metrics
gsb_frais_submits_total{statut="ok"} 248
gsb_frais_submits_total{statut="erreur"} 7
# → taux d'erreur = 7 / (248 + 7) = 2.7 % (à alerter si > 5 %)
Latence : moyenne vs p95
La moyenne des temps de réponse est trompeuse : 10 requêtes à 50 ms et 1 requête à 10 s donnent une moyenne d'environ 954 ms (10 500 ms ÷ 11) — la moyenne est tirée vers le haut par une seule requête lente, alors que la médiane (p50) reste à 50 ms et masque cet utilisateur qui a attendu 10 s. En production, on mesure les percentiles.
| Percentile | Définition | Seuil d'alerte raisonnable (API REST) |
|---|---|---|
| p50 (médiane) | 50 % des requêtes sont plus rapides que cette valeur | < 200 ms |
| p95 | 95 % des requêtes sont plus rapides — les 5 % les plus lents sont exclus | < 500 ms |
| p99 | 99 % des requêtes sont plus rapides — 1 % de cas extrêmes | < 2 s |
| p99,9 | 1 requête sur 1000 dépasse cette valeur | contexte financier / santé : < 5 s |
Flag D1
Investigation
Documente-toi sur Prometheus + Grafana (ou un outil équivalent). Rends : à quoi sert chacun, comment ils se complètent, et 3 métriques utiles à suivre sur AppliFrais (avec un seuil d'alerte raisonnable pour chacune, en justifiant le choix du seuil).
4. Alertes & réaction
Mesurer ne sert à rien si personne n'est prévenu au bon moment. L'alerte transforme une métrique en action.
| Bonne pratique d'alerte | Pourquoi | Contre-exemple (à éviter) |
|---|---|---|
| Alerter sur un seuil utile | seuil trop bas = bruit ; trop haut = panne passée sous le radar | « CPU > 50 % » → faux positifs en permanence |
| Confirmer avant d'alerter | un pic de 30 s n'est pas une panne ; confirmer 2-3 mesures réduit les faux positifs | alerter au 1er code 503, même si le service repart seul en 10 s |
| Plusieurs canaux selon gravité | toutes les alertes au même niveau = on décroche à 3h pour rien | email pour une panne critique (noyé dans la boîte le matin) |
| Runbook associé | à 3h, on ne cherche pas quoi faire : on suit le runbook | « vérifier les logs » (trop vague, personne ne sait où) |
| Limiter à 3-5 alertes actives max | au-delà, la fatigue d'alerte s'installe et les vraies pannes sont ignorées | 20 règles d'alerte sur 20 métriques différentes |
Format d'une règle d'alerte (Uptime Kuma / AlertManager)
Une règle d'alerte se définit avec trois éléments : la condition, le délai de confirmation, et la sévérité.
| Règle | Condition | Délai de confirmation | Sévérité | Canal |
|---|---|---|---|---|
| AppliFrais DOWN | /health renvoie non-200 ou timeout | 2 échecs consécutifs (2 min) | critique | email + SMS + push |
| Latence élevée | p95 des requêtes > 500 ms sur 5 min | 2 mesures Prometheus | avertissement | email / Slack |
| Taux d'erreurs élevé | rate de 5xx > 5 % sur 5 min | 2 mesures | critique | email + push |
| Disque presque plein | espace libre < 10 % | 1 mesure (lent à évoluer) | avertissement |
Template de runbook (à compléter pour chaque alerte)
Un runbook n'est pas un roman. C'est une liste numérotée d'actions rédigée à froid, suivie à chaud à 3h du matin.
## Runbook : AppliFrais /health KO > 2 min
Date de creation : 2026-01-14   Auteur : [ton nom]
Alerte declenchee par : moniteur Uptime Kuma /health

### 1. Verifier que c'est reel (30 s)
curl -i https://appli-frais.fr/health
  → 200 ? faux positif, silencer l'alerte.
  → 503 ou timeout ? continuer.

### 2. Identifier la cause (2 min)
# logs applicatifs (si acces SSH)
pm2 logs applifrais --lines 50
# ou si Docker
docker logs applifrais --tail=50

# etat de MongoDB
docker exec applifrais-mongo mongosh --eval "db.adminCommand('ping')"

### 3. Remediation rapide
# scenario A : l'app est arretee
pm2 restart applifrais          # ou : docker restart applifrais

# scenario B : Mongo est down
docker restart applifrais-mongo
# attendre 10 s, re-verifier /health

# scenario C : serveur sature (RAM/CPU)
free -h && df -h && top -bn1 | head -20

### 4. Confirmer la resolution
curl -i https://appli-frais.fr/health   # attendre 200

### 5. Post-mortem (dans les 24 h)
Documenter : heure debut/fin, cause, action, prevention future.
Flag B3
Production (alerte + runbook)
Définis une alerte utile sur AppliFrais (ex. « /health KO > 2 min ») et écris le runbook associé en utilisant le template ci-dessus, adapté à ton déploiement. Rends : ta règle d'alerte (condition + délai + canal) + ton runbook complet.
Chapitre 4 bis — Logs structurés : le troisième pilier
La supervision repose sur trois piliers complémentaires : les logs (ce qui s'est passé), les métriques (comment le service se comporte en chiffres), et les traces (le chemin d'une requête à travers les services). Les deux premiers sont les plus importants pour AppliFrais.
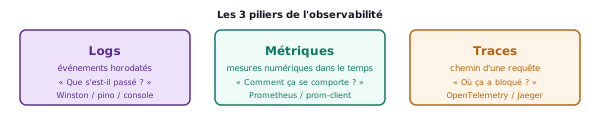
En BTS SIO, tu travailles surtout les logs et les métriques. Les traces sont une technique avancée (microservices) que tu rencontreras en entreprise.
Logs texte vs logs structurés
Le problème du console.log : il produit du texte libre, impossible à filtrer ou à analyser automatiquement. Les logs structurés (JSON) permettent à un outil de les indexer et de les rechercher.
// Log texte (ce que font les debutants)
console.log('POST /frais - 201 - 142ms');

// Log structure (ce que font les pros) - avec la librairie pino
const pino = require('pino');
const log = pino({ level: 'info' });

// dans la route POST /frais
log.info({
  method: 'POST',
  path:   '/frais',
  status: 201,
  ms:     142,
  userId: req.user?.id,
  ficheId: fiche._id
}, 'fiche de frais creee');
# sortie pino (une ligne JSON par event)
{"level":30,"time":1705220400000,"pid":1234,"hostname":"vps-gsb",
 "method":"POST","path":"/frais","status":201,"ms":142,
 "userId":"664f…","ficheId":"665a…","msg":"fiche de frais creee"}

# filtre avec jq (afficher uniquement les erreurs)
node app.js | jq 'select(.level >= 50)'
# → n'affiche que les warn/error/fatal
Ce qu'on log TOUJOURS en production
| Évènement | Niveau | Champs obligatoires | Pourquoi |
|---|---|---|---|
| Démarrage de l'app | info | version, port, env (prod/dev) | confirmer la bonne version déployée |
| Chaque requête HTTP | info | method, path, status, ms, userId | audit trail, debug latence |
| Erreur 4xx (client) | warn | path, status, message, userId, ip | détecter abus ou bug client |
| Erreur 5xx (serveur) | error | path, stack trace, userId | diagnostic, alerte urgente |
| Action sensible (login, validation comptable) | info | userId, action, ficheId, ip | audit RGPD, responsabilité |
| Crash / exception non catchée | fatal | stack trace complète | arrêt immédiat, alerte critique |
5. Mini-projet : AppliFrais observable
La mission
Rends AppliFrais observable de bout en bout et documente sa supervision :
- un health check qui teste l'API et la base ;
- un monitoring d'uptime externe avec alerte ;
- au moins une métrique suivie (latence ou erreurs) ;
- une règle d'alerte + son runbook ;
- un objectif de disponibilité (SLA) affiché et mesuré.
Flag B4
Mini-projet (livrable)
Livre la supervision d'AppliFrais : health check + monitoring + alerte + runbook + objectif d'uptime. Rends : le dispositif (captures, configs, doc) + ton uptime mesuré sur la période. « J'ai assuré et mesuré la disponibilité du service » est une phrase qui marque en E5.
Flag E1
Extension (page de statut)
Va plus loin que le strict nécessaire : monte un Uptime Kuma en conteneur Docker (docker run -d --restart=always -p 3001:3001 -v uptime-kuma:/app/data louislam/uptime-kuma), ajoute un moniteur sur /health, et publie une page de statut (status page) lisible par les utilisateurs d'AppliFrais. Rends : l'URL/capture de ta page de statut + une période d'uptime affichée.
Pour finir
L'essentiel
| Notion | À retenir |
|---|---|
| disponibilité | se mesure en uptime % ; définir un objectif (SLA) |
| health check | endpoint qui teste l'app ET ses dépendances |
| monitoring | surveiller de l'extérieur ; alerter en 1-2 min |
| métriques & alertes | latence/erreurs/trafic/saturation ; alertes rares et actionnables |
Vérifie tes acquis
- Que signifie un uptime de 99,9 % en heures d'indisponibilité par an ? (donne la valeur exacte)
- Pourquoi un health check teste-t-il aussi la base, pas juste l'API ? Donne un exemple concret de cas où l'API répond 200 mais la base est morte.
- Pourquoi surveiller de l'extérieur et pas depuis le serveur lui-même ?
- Quels sont les 4 signaux dorés à mesurer (au-delà du up/down) ? Pour chacun, donne un exemple de seuil d'alerte raisonnable.
- Pourquoi trop d'alertes est-il un problème ? Quel terme désigne ce phénomène ?
- À quoi sert un runbook ? Quels sont ses 5 éléments essentiels (d'après le template du chapitre 4) ?
- Quelle est la différence entre un log texte (
console.log) et un log structuré (JSON) ? Pourquoi le second est-il préféré en production ? - Quelle est la différence entre RTO et RPO ? Donne un exemple d'impact concret pour AppliFrais.
- Un service affiche p50 = 80 ms mais p99 = 8 s. Que peut-on en déduire ? Est-ce un problème ?
- Cite une donnée qu'il ne faut jamais loguer en production et explique pourquoi (RGPD).
Glossaire
| Mot | Définition | À retenir |
|---|---|---|
| Disponibilité (uptime) | % de temps où le service répond correctement sur une période donnée | 99,9 % = 8,76 h/an de tolérance |
| SLA — Service Level Agreement | engagement contractuel de disponibilité envers le client | ex. « 99,9 % garanti ou remboursement » |
| SLO — Service Level Objective | objectif interne de disponibilité, plus ambitieux que le SLA | SLA = 99,9 % → SLO = 99,95 % (marge) |
| SLI — Service Level Indicator | la mesure effective (ex. % de requêtes sans erreur) | SLI mesure → SLO objectif → SLA engagement |
| MTTR — Mean Time To Repair | temps moyen de résolution d'une panne | cible prod : < 30 min |
| RTO — Recovery Time Objective | durée max tolérée avant reprise de service après sinistre | définit la vitesse de réaction minimale |
| RPO — Recovery Point Objective | volume max de données perdables (= fréquence de sauvegarde requise) | RPO 1 h → sauvegarde toutes les heures |
| Health check | endpoint /health qui teste l'app ET ses dépendances critiques | répond 200 (sain) ou 503 (dégradé) en < 1 s |
| Monitoring | surveillance continue, externe, avec alertes automatiques | différent de « regarder les logs manuellement » |
| Scraping | action de Prometheus : il vient lire /metrics à intervalle régulier | par défaut toutes les 15 s |
| Métrique | mesure chiffrée (latence, erreurs, CPU…) indexée dans le temps | Counter (monte) vs Gauge (monte et descend) vs Histogram |
| p95 / p99 | percentile : 95 % (ou 99 %) des requêtes sont plus rapides que cette valeur | plus parlant que la moyenne pour l'expérience utilisateur |
| Alert fatigue | phénomène où trop d'alertes conduit à les ignorer toutes | cible : < 5 alertes/semaine, toutes actionnables |
| Runbook | procédure numérotée de diagnostic et réaction à une alerte | doit répondre à « que faire quand cette alerte tombe à 3h » |
| Observabilité | capacité à comprendre l'état interne d'un système depuis ses sorties (logs, métriques, traces) | monitoring = surveiller ; observabilité = comprendre |
| Log structuré | log au format JSON (champs fixes), filtrable/indexable par des outils | pino, winston — vs console.log texte libre |
| PM2 | gestionnaire de process Node.js en production (redémarre automatiquement, gère les logs) | pm2 start app.js --name applifrais |
Connecte-toi pour lire tout le TP
C'est gratuit, avec ton compte Google : un clic, et tu reviens ici. Ta progression te suit ensuite sur tous tes appareils.
Le site garde ton nom et ton email, rien d'autre. Tes données