TP2e année8 livrables
Sauvegarde & plan de reprise
Une question, une seule : si le serveur d'AppliFrais brûle cette nuit, combien de données perds-tu, et en combien de temps remets-tu le service en route ? Si tu n'as pas la réponse chiffrée, tu n'es pas protégé. Aujourd'hui tu mets en place des sauvegardes fiables, tu testes une restauration, et tu rédiges un plan de reprise. La survie de tes données.
Par Josselyn C., prof de BTS SIO. Publié le .
- Objectif
- mettre en place sauvegardes, restauration testée et plan de reprise pour AppliFrais
- On manipule
- un dump MongoDB, une stratégie 3-2-1, RTO/RPO, un PRA
- Pré-requis
- AppliFrais déployé, base MongoDB
- Pour qui
- SLAM, 2e année
- Durée
- 1 séance
Compétences : C3.4 Garantir la disponibilité, l'intégrité et la confidentialité des services informatiques et des données de l'organisation face à des cyberattaques, C1.5 Mettre à disposition des utilisateurs un service informatique
Une sauvegarde jamais restaurée n'est pas une sauvegarde. La garantie DICP repose là-dessus.
Avant de commencer
Pourquoi cette séance
Tout le travail de déploiement et de supervision ne sert à rien si, le jour d'un sinistre (panne disque, ransomware, erreur humaine, incendie du datacenter), tu perds les données ou tu ne sais pas redémarrer. La sauvegarde et le plan de reprise sont l'assurance-vie de ton service. C'est le volet « garantir la disponibilité et l'intégrité » du Bloc 3 (DICP). On va voir comment sauvegarder AppliFrais correctement (pas juste « faire un dump de temps en temps »), comment chiffrer et tester ces sauvegardes (une sauvegarde jamais restaurée est une illusion), et comment formaliser un plan de reprise avec des objectifs chiffrés.
Ce que tu vas apprendre
| Concept | Ce que tu sauras faire |
|---|---|
| RTO / RPO | chiffrer ce que tu peux te permettre de perdre |
| Règle 3-2-1 | structurer des sauvegardes fiables |
| Sauvegarde Mongo | faire un dump automatisé et chiffré |
| Restauration | tester la remise en service (le test qui compte) |
| PRA / PCA | rédiger un plan de reprise d'activité |
0. RTO & RPO : chiffrer le risque
Avant de sauvegarder, deux questions chiffrées qui pilotent toute la stratégie. Ce sont les deux indicateurs clés de la reprise.
| Indicateur | Question | Exemple AppliFrais |
|---|---|---|
| RPO (Recovery Point Objective) | combien de données puis-je perdre ? | « au plus 24 h » → sauvegarde quotidienne |
| RTO (Recovery Time Objective) | en combien de temps dois-je redémarrer ? | « en moins de 4 h » → procédure rapide |
Ordres de grandeur réels par secteur d'activité
| Secteur | RPO typique | RTO typique | Pourquoi si exigeant |
|---|---|---|---|
| Banque / paiement | < 15 s (réplication synchrone) | < 1 min (bascule auto) | chaque seconde = milliers de transactions perdues |
| Hôpital / urgences | < 1 h | < 15 min | perte de données patient = risque vital, obligation légale |
| E-commerce (Black Friday) | < 5 min | < 30 min | ~5 000 € de CA perdu par minute d'indisponibilité (moyenne secteur) |
| PME / back-office interne | 24 h | 4-8 h | gêne opérationnelle mais pas de risque immédiat |
| GSB AppliFrais (notre cas) | 24 h | 4 h max | notes de frais : saisie reportable, utilisateurs tolérants |
SLA et uptime — les maths derrière les pourcentages
| Disponibilité annuelle | Indisponibilité max/an | Indisponibilité max/mois | RTO compatible |
|---|---|---|---|
| 99 % (« deux neuf ») | 3 j 15 h 36 min | 7 h 18 min | < 4 h |
| 99,9 % (« trois neuf ») | 8 h 45 min | 43 min | < 30 min |
| 99,99 % (« quatre neuf ») | 52 min | 4,3 min | < 5 min |
| 99,999 % (« cinq neuf ») | 5 min 15 s | 26 s | < 1 min |
Le plus clair, c'est de poser les deux sur une ligne de temps autour du sinistre : le RPO regarde vers le passé (les données depuis la dernière sauvegarde), le RTO regarde vers le futur (le temps de remise en route).
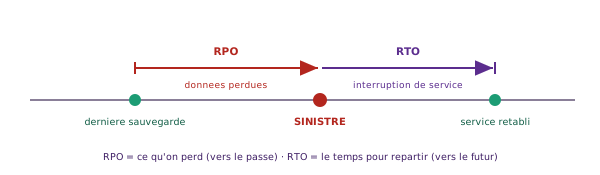
Plus la sauvegarde est recente, plus le RPO est petit. Plus la procedure est rodee, plus le RTO est petit.
Flag A1
Checkpoint
Pour AppliFrais, propose un RPO et un RTO justifiés par le besoin métier, et déduis-en la fréquence de sauvegarde nécessaire. Rends : tes deux valeurs + leur justification + la fréquence.
1. La règle 3-2-1
Une sauvegarde, c'est bien. Une sauvegarde fiable suit la règle 3-2-1, le standard mondial.
| Chiffre | Signifie | Pourquoi |
|---|---|---|
| 3 copies | l'original + 2 sauvegardes | une seule sauvegarde peut être corrompue |
| 2 supports | sur 2 types de média différents | ne pas dépendre d'un seul type de panne |
| 1 hors site | au moins une copie ailleurs | survivre à un sinistre local (incendie, vol) |
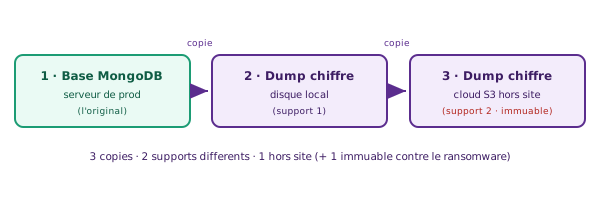
La regle 3-2-1 appliquee a AppliFrais : l'original sur le serveur, un dump local, un dump hors site et immuable.
Comparaison des supports de stockage pour la copie hors-site
| Support | Coût typique | RPO min. réaliste | Avantages | Pièges |
|---|---|---|---|---|
| Disque local / NAS | ~0,05 €/Go (achat) | Quelques minutes | Rapide, pas de réseau | Détruit avec le serveur en cas d'incendie ou ransomware ; pas hors-site |
| AWS S3 / OVH Object Storage | 0,02–0,023 €/Go/mois | 1-5 min (transfert réseau) | Hors-site, scalable, object lock disponible, API standard | Coût de sortie (egress) : ~0,09 €/Go sorti — attention à la restauration massive |
| Backblaze B2 | 0,006 €/Go/mois | 1-5 min | 4× moins cher que S3, egress gratuit vers CDN partenaires | Moins d'intégrations natives que AWS |
| MinIO (auto-hébergé) | Coût infra seulement | 1-5 min (LAN ou VPN) | API S3 compatible, object lock supporté, aucune donnée chez un tiers | Tu gères toi-même la disponibilité et les mises à jour |
| Bande (LTO-9) | ~0,002 €/Go (médium) | 24-48 h (logistique) | Air-gap total, immuable physiquement, archives long terme 30+ ans | Lecteur coûteux (~5 000 €), restauration lente, uniquement pour archives froides |
Flag B1
Production
Conçois la stratégie de sauvegarde 3-2-1 d'AppliFrais : quelles copies, sur quels supports, où (dont une hors site). Rends : ton schéma 3-2-1 appliqué à AppliFrais (base + dumps).
2. Sauvegarder MongoDB (dump automatisé)
Concrètement, on sauvegarde la base d'AppliFrais avec mongodump, on chiffre l'archive, et on automatise.
#!/bin/bash
# sauvegarde-appli-frais.sh
DATE=$(date +%F_%H%M)
mongodump --uri="$MONGO_URI" --archive=/backups/appli-$DATE.archive --gzip   # (1)
gpg --encrypt --recipient backup@gsb /backups/appli-$DATE.archive            # (2)
aws s3 cp /backups/appli-$DATE.archive.gpg s3://gsb-backups/                  # (3)
find /backups -name "*.archive*" -mtime +7 -delete                           # (4)
Quand tu lances le script à la main pour vérifier, voici ce que tu dois voir à l'écran :
$ ./sauvegarde-appli-frais.sh
2027-01-15T02:00:03.412+0000  writing applifrais.users to archive
2027-01-15T02:00:03.998+0000  writing applifrais.fiches to archive
2027-01-15T02:00:04.205+0000  writing applifrais.lignes to archive
2027-01-15T02:00:04.713+0000  done dumping applifrais.fiches (842 documents)
gpg: writing to '/backups/appli-2027-01-15_0200.archive.gpg'
upload: ./appli-2027-01-15_0200.archive.gpg to s3://gsb-backups/appli-2027-01-15_0200.archive.gpg
$ ls /backups
appli-2027-01-15_0200.archive.gpg
On automatise ensuite avec une ligne de cron (le planificateur de tâches sous Linux) :
# crontab -e   (tous les jours a 2h du matin)
0 2 * * * /opt/sauvegarde-appli-frais.sh >> /var/log/backup.log 2>&1
Détail pro : options mongodump à connaître
| Option | Rôle | Quand l'utiliser |
|---|---|---|
--archive= | Écrit tout dans un seul fichier (au lieu d'un répertoire BSON) | Toujours pour les sauvegardes automatisées (plus simple à chiffrer et transférer) |
--gzip | Compresse à la volée (~70-80 % de gain pour du JSON/BSON) | Toujours (quasi-gratuit en CPU, gain de stockage et réseau majeur) |
--oplog | Capture le journal d'opérations en cours de dump (pour cohérence à la milliseconde) | Sur un replica set actif avec écritures simultanées ; sur une base standalone, inutile |
--collection= | Dump d'une seule collection | Restauration partielle rapide (ex. : « je veux juste récupérer la collection fiches ») |
--excludeCollection= | Exclure une collection | Ignorer les collections volumineuses de logs si le contenu est jetable |
--readPreference=secondary | Lire depuis un réplica secondaire | Éviter d'impacter la prod sur un replica set ; le primaire n'est pas stressé |
Gestion de la clé GPG — le piège oublié
Compatibilité de versions — un piège de restauration réel
Flag B2
Production (sauvegarde)
Mets en place une sauvegarde automatisée de la base AppliFrais : mongodump + chiffrement + copie hors site, planifiée par cron.
Rends : ton script + la planification cron + la preuve d'une sauvegarde produite (le .gpg listé et la sortie du dump).
3. Le test qui compte : la restauration
Voici la vérité que beaucoup apprennent trop tard : une sauvegarde n'a aucune valeur tant qu'on n'a pas testé sa restauration. Des sauvegardes corrompues, incomplètes ou inrestaurables, c'est extrêmement courant.
# restaurer la base depuis une archive (sur un environnement de TEST) :
gpg --decrypt appli-2027-01-15_0200.archive.gpg > appli.archive    # (1) dechiffrer
mongorestore --uri="$MONGO_TEST_URI" --archive=appli.archive --gzip # (2) restaurer
$ gpg --decrypt appli-2027-01-15_0200.archive.gpg > appli.archive
gpg: encrypted with rsa3072 key, ID 9F3A..., "GSB Backup <backup@gsb>"
$ mongorestore --uri="$MONGO_TEST_URI" --archive=appli.archive --gzip
2027-01-15T10:12:01.004+0000  preparing collections to restore from
2027-01-15T10:12:01.661+0000  restoring applifrais.fiches from archive
2027-01-15T10:12:02.880+0000  finished restoring applifrais.fiches (842 documents)
2027-01-15T10:12:03.210+0000  842 document(s) restored successfully. 0 document(s) failed to restore.
La sauvegarde est restaurée. Mais le test ne compte que si tu vérifies ensuite que les données sont complètes et exploitables :
# (3) verifier : compter les documents et tester un acces
mongosh "$MONGO_TEST_URI" --eval 'db.fiches.countDocuments()'
842
Erreurs courantes lors de la restauration
Planifier et tracer les tests de restauration
La règle professionnelle : un test de restauration toutes les 4-8 semaines, tracé dans un registre. Voici le tableau de suivi minimal :
| Date du test | Dump utilisé (date) | Nb de documents restaurés | RTO mesuré | Résultat | Testeur |
|---|---|---|---|---|---|
| 2027-01-20 | 2027-01-15 | 842 | 1 h 10 min | OK — login + fiche vérifiés | Alice |
| 2027-02-17 | 2027-02-16 | 1 038 | 1 h 05 min | OK | Bob |
| … | … | … | … | … | … |
Flag B3
Production (restauration testée)
Restaure une sauvegarde d'AppliFrais sur un environnement de test et vérifie son intégrité (nombre de documents, un login, une fiche). Rends : la procédure + la preuve que les données restaurées sont complètes et exploitables.
4. Le plan de reprise (PRA / PCA)
Au-delà de la base, le plan de reprise d'activité (PRA) formalise comment on remet tout le service en route après un sinistre. À distinguer du PCA.
| Plan | Objectif |
|---|---|
| PRA (Plan de Reprise d'Activité) | redémarrer après un sinistre (accepte une interruption) |
| PCA (Plan de Continuité d'Activité) | ne jamais s'interrompre (redondance, bascule auto) |
PRA vs PCA — quand choisir lequel, et à quel coût
| Critère | PRA (Plan de Reprise) | PCA (Plan de Continuité) |
|---|---|---|
| Interruption | Oui, interruption acceptée (quelques heures) | Non — bascule transparente, RTO < 1 min |
| Architecture | Serveur de secours « froid » (éteint ou minimal) | Serveur de secours « chaud » en permanence, synchronisé en temps réel |
| Mécanisme | Procédure manuelle : restaurer, reconfigurer, redémarrer | Load balancer + health check + bascule automatique (failover) |
| Coût infra | Faible (serveur de secours minimal ou cloud à la demande) | 2× à 5× le coût de la prod (infra doublée, active en permanence) |
| Complexité | Documentable par un développeur junior | Nécessite architecture réseau avancée (Keepalived, DNS TTL court, réplication synchrone) |
| Adapté à | PME, applications internes, BTS SIO | Banques, hôpitaux, e-commerce critique |
| Norme de référence | ISO 22301 (management de la continuité d'activité) — le référentiel international |
Un PRA n'est pas un texte vague : c'est une suite d'étapes ordonnées, chacune avec un responsable et une durée estimée, dont la somme doit tenir dans le RTO. Voici le squelette à remplir pour AppliFrais :
| # | Étape de reprise | Qui | Durée visée |
|---|---|---|---|
| 1 | Constater le sinistre, déclencher le PRA, prévenir l'équipe | Admin | 15 min |
| 2 | Provisionner un serveur sain (VM/host de secours) | Admin | 30 min |
| 3 | Redéployer l'app (Docker / doc de déploiement, dépôt Git) | Dev | 30 min |
| 4 | Récupérer la dernière sauvegarde hors site et la déchiffrer | Admin | 20 min |
| 5 | Restaurer la base (mongorestore) et reconfigurer les accès | Dev | 25 min |
| 6 | Vérifier (login, nombre de fiches, ouverture d'une fiche) | Dev | 15 min |
| 7 | Rouvrir le service aux utilisateurs, journaliser l'incident | Admin | 10 min |
Flag B4
Production (PRA)
Rédige le PRA d'AppliFrais : les étapes ordonnées pour tout remettre en route après une perte totale du serveur (réinstaller, restaurer, reconfigurer, vérifier), avec le RTO/RPO visés et les rôles. Rends : ton PRA.
5. Mini-projet : protéger AppliFrais
La mission
Mets en place la protection complète des données d'AppliFrais et documente-la :
- RTO/RPO définis et justifiés ;
- sauvegarde automatisée (dump chiffré, hors site, planifiée), 3-2-1 ;
- restauration testée et vérifiée ;
- PRA écrit (étapes, rôles, RTO/RPO) ;
- un journal attestant que les sauvegardes tournent.
Flag B5
Mini-projet (livrable)
Livre le dispositif complet de sauvegarde & reprise d'AppliFrais (script + cron + restauration testée + PRA + RTO/RPO). Rends : le tout. « J'ai mis en place et testé une stratégie de sauvegarde et un PRA » est une réalisation de portfolio E5 qui prouve la maîtrise de la DICP.
Rétention GFS (grand-père / père / fils) — la stratégie de conservation pro
Garder toutes les sauvegardes quotidiennes indéfiniment remplit le stockage. La stratégie professionnelle est la rétention GFS (Grandfather-Father-Son), qui conserve des sauvegardes à plusieurs granularités :
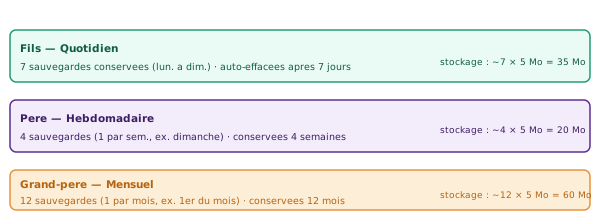
Strategie GFS : 7 + 4 + 12 = 23 sauvegardes conservees, couvrant les 12 derniers mois, pour ~115 Mo totaux (AppliFrais). Sans GFS : 365 sauvegardes quotidiennes = 1,8 Go.
Flag D1
Investigation (sauvegardes immuables)
Cherche dans la doc comment rendre une copie réellement à l'abri d'un attaquant qui a pris la main sur le serveur.
À chercher : ce qu'est le « object lock » (verrouillage objet) S3/MinIO et ce qu'est une rétention « grand-père / père / fils » (quotidiennes 7 j, hebdomadaires 4 sem, mensuelles 12 mois).
Rends : en 5-6 lignes, ce qu'apporte l'object lock face au ransomware + ton schéma de rétention pour AppliFrais.
Flag E1
Extension (sauvegarder aussi les fichiers)
Une base, ce n'est pas tout l'état d'AppliFrais : les justificatifs (images des notes de frais) vivent dans S3/MinIO. Une restauration de la base seule rendrait des fiches qui pointent vers des fichiers disparus.
À toi : étends ta sauvegarde pour inclure aussi le bucket des justificatifs (ex. aws s3 sync vers une copie hors site), chiffré.
Rends : ton script étendu (base + fichiers) + l'explication de pourquoi les deux doivent être cohérents dans le temps.
Pour finir
L'essentiel
| Notion | À retenir |
|---|---|
| RTO / RPO | combien de temps / combien de données — pilotent la stratégie |
| 3-2-1 | 3 copies, 2 supports, 1 hors site (+ immuable contre ransomware) |
| sauvegarde | dump chiffré, automatisé (cron), hors site |
| restauration & PRA | tester la restauration ; PRA écrit et répété |
Vérifie tes acquis
- Différence entre RTO et RPO ?
- Que signifie la règle 3-2-1, et pourquoi 1 copie hors site ?
- Pourquoi une sauvegarde non testée n'est-elle pas une sauvegarde ?
- Pourquoi chiffrer les sauvegardes (lien RGPD) ?
- Différence entre un PRA et un PCA ?
- En quoi le ransomware change-t-il la stratégie de sauvegarde ?
- Que risque-t-on à stocker la clé GPG sur le même serveur que les sauvegardes ?
- Quelle est la règle de rétention GFS, et pourquoi conserver des sauvegardes mensuelles sur 12 mois ?
- Pour une banque, quel RPO est réaliste, et pourquoi ce RPO change radicalement l'architecture ?
Corrigé — auto-vérification
Voir le corrigéMasquer le corrigé
- RTO vs RPO : le RPO (Recovery Point Objective) = combien de données on accepte de perdre (regarder vers le passé : depuis la dernière sauvegarde) ; le RTO (Recovery Time Objective) = combien de temps on accepte d'être en panne (regarder vers le futur : temps pour redémarrer). Ex. RPO 24 h = accepte de perdre 24 h de données ; RTO 4 h = doit repartir en < 4 h.
- 3-2-1 : 3 copies, sur 2 supports différents (ex. disque local + cloud), dont 1 hors site. Hors site = survie à un incendie, un vol ou un ransomware qui a chiffré le serveur entier et le NAS local.
- Sauvegarde non testée : l'archive peut être corrompue, incomplète, ou inrestaurab sur la version Mongo actuelle. On ne le découvre que le jour du sinistre, trop tard. Une sauvegarde jamais restaurée = illusion de protection.
- Chiffrement et RGPD : les sauvegardes contiennent des données personnelles (noms, emails, fiches de frais). Les stocker hors site sans chiffrement expose ces données à quiconque y accède (hébergeur, fuite). Le RGPD (art. 32) impose des mesures techniques de protection — le chiffrement en est une.
- PRA vs PCA : PRA = redémarrer après une coupure (procédure manuelle, coût faible) ; PCA = ne jamais couper (infrastructure doublée, bascule automatique, coût 2-5×). Pour une PME ou AppliFrais, le PRA suffit.
- Ransomware et stratégie : un ransomware chiffre aussi les sauvegardes montées/accessibles depuis le serveur compromis. Remède : sauvegardes immuables (object lock S3) ou déconnectées (air-gap). D'où le 3-2-1-1-0 : 1 copie immuable ou hors-ligne + 0 erreur de restauration prouvée.
- Clé GPG : si la clé privée est sur le serveur sinistré, impossible de déchiffrer la sauvegarde — toutes les sauvegardes chiffrées sont inaccessibles. Il faut exporter et conserver la clé privée dans un coffre séparé (password manager, Vault, coffre physique).
- Rétention GFS : Grandfather-Father-Son = quotidien 7 jours + hebdomadaire 4 semaines + mensuel 12 mois. Mensuelles sur 12 mois : certains ransomwares restent dormants plusieurs semaines avant de se déclencher ; avoir 8 mois de recul permet de restaurer des données avant contamination.
- RPO banque : RPO < 15 secondes (voire 0 par réplication synchrone). Cela exige des bases de données en cluster synchrone (Primary/Secondary) avec confirmation d'écriture sur plusieurs nœuds avant d'acquitter la transaction. L'architecture bascule vers MongoDB Replica Set ou PostgreSQL en mode synchrone — impossible à mettre en place avec un simple dump cron.
Glossaire
| Mot | Définition |
|---|---|
| RPO | Recovery Point Objective — quantité max de données acceptée comme perdue (pilote la fréquence de sauvegarde) |
| RTO | Recovery Time Objective — délai max pour redémarrer (pilote la complexité de la procédure) |
| DICP | Disponibilité, Intégrité, Confidentialité, Preuve — les 4 piliers de la sécurité de l'information (référentiel ANSSI / Bloc 3) |
| 3-2-1 | 3 copies, 2 supports différents, 1 hors site — règle minimale de sauvegarde fiable |
| 3-2-1-1-0 | Extension : +1 copie immuable ou hors-ligne (contre ransomware), +0 erreur de restauration vérifiée |
| mongodump / mongorestore | Outils officiels MongoDB (paquet mongodb-database-tools) pour sauvegarder/restaurer en format BSON compressé |
| BSON | Binary JSON — format binaire de MongoDB, plus compact et plus rapide que JSON texte |
| GPG (GnuPG) | Outil de chiffrement asymétrique open-source ; on chiffre avec la clé publique, on déchiffre avec la clé privée |
| Object lock (S3) | Verrou d'immuabilité S3 : un objet verrouillé ne peut être ni modifié ni supprimé pendant la durée de rétention, même par le compte propriétaire |
| Air-gap | Isolation physique : la copie de sauvegarde n'est jamais connectée au réseau (bande magnétique hors-ligne, disque déconnecté) — inattaquable à distance |
| GFS (Grand-père / Père / Fils) | Stratégie de rétention à 3 niveaux : quotidien 7 j + hebdo 4 sem + mensuel 12 mois |
| cron | Planificateur de tâches Unix/Linux ; syntaxe minute heure jour mois joursemaine commande |
| PRA | Plan de Reprise d'Activité — procédure pour redémarrer après sinistre (interruption acceptée) |
| PCA | Plan de Continuité d'Activité — maintien du service sans interruption (bascule automatique) |
| ISO 22301 | Norme internationale de management de la continuité d'activité — cadre de référence pour PRA/PCA |
| SLA | Service Level Agreement — contrat définissant les niveaux de disponibilité, RTO/RPO, et pénalités en cas de dépassement |
| Replica Set | Groupe de nœuds MongoDB avec réplication automatique (1 primaire + N secondaires) — permet failover automatique et RPO proche de 0 |
| Oplog | Operations Log — journal interne MongoDB d'un Replica Set enregistrant chaque opération d'écriture ; utilisé par mongodump pour garantir la cohérence lors d'un dump live |
Connecte-toi pour lire tout le TP
C'est gratuit, avec ton compte Google : un clic, et tu reviens ici. Ta progression te suit ensuite sur tous tes appareils.
Le site garde ton nom et ton email, rien d'autre. Tes données