Séance 2 sur 217 livrables
SQL (2) : filtrer, trier, compter
Tu sais lire et filtrer. Maintenant on CALCULE : combien de commandes ? quel total de frais par visiteur ? le produit le plus cher ? Et on relie enfin deux tables. C'est là que les données deviennent des informations.
Par Josselyn C., prof de BTS SIO. Publié le , mis à jour le .
- Objectif
- agréger (COUNT, SUM, AVG, MIN, MAX), regrouper (GROUP BY), filtrer des groupes (HAVING), relier des tables (JOIN)
- On manipule
- une base GSB à 2 tables (visiteur, frais), dans un outil SQL
- Pré-requis
- savoir écrire un SELECT … WHERE (séance SQL 1)
On passe des données brutes aux vraies statistiques métier — exactement ce qu'on demande à un dev.
Avant de commencer
Pourquoi ces requêtes changent tout
Lire une liste, c'est utile. Mais une entreprise veut surtout des chiffres : combien de clients ? quel chiffre d'affaires ce mois ? le total des frais par visiteur ? C'est le rôle des fonctions d'agrégation et du GROUP BY. Et pour croiser des infos de plusieurs tables (les frais ET le nom du visiteur), il faut les relier avec un JOIN. Ces requêtes sont le cœur du métier de développeur côté données.
Ce que tu sauras faire à la fin
| Mot-clé | Tu sauras… |
|---|---|
COUNT / COUNT(DISTINCT) | compter des lignes, compter sans doublons |
SUM / AVG / MIN / MAX | totaliser, moyenner, trouver les extrêmes |
ROUND | arrondir un résultat (une moyenne) |
GROUP BY | calculer par groupe (par ville, par visiteur…), sur 1 ou plusieurs colonnes |
HAVING | filtrer les groupes |
JOIN / LEFT JOIN | relier deux tables, en gardant ou non les « sans correspondance » |
| l'ordre des clauses | combiner WHERE + GROUP BY + HAVING + ORDER BY proprement |
0. La base de jeu
On reprend deux tables GSB. Crée-les dans l'outil (sqliteonline) :
CREATE TABLE visiteur (id INT, nom TEXT, ville TEXT);
INSERT INTO visiteur VALUES (1,'Marc','Lyon'),(2,'Sophie','Paris'),(3,'Karim','Lyon');

CREATE TABLE frais (id INT, id_visiteur INT, montant DECIMAL, type TEXT);
INSERT INTO frais VALUES
 (1,1,45.50,'Restaurant'),(2,1,120.00,'Hotel'),
 (3,3,12.00,'Transport'),(4,2,89.90,'Hotel'),(5,3,60.00,'Restaurant');
Flag B1
Production
Crée les deux tables avec leurs données. Rends : confirme que frais contient 5 lignes (SELECT * FROM frais;).
1. Compter : COUNT
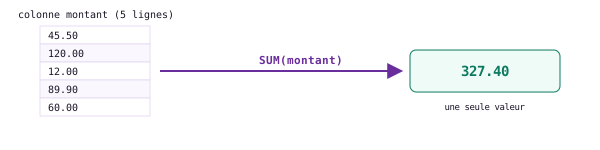
Agréger = réduire plusieurs lignes à un résultat unique. COUNT, SUM, AVG, MIN, MAX font toutes ça.
COUNT compte le nombre de lignes d'un résultat.
SELECT COUNT(*) FROM frais;
Compter avec une condition
SELECT COUNT(*) FROM frais WHERE type = 'Hotel';
Compter les valeurs DIFFÉRENTES : COUNT(DISTINCT …)
« Combien de frais ? » → 5. Mais « combien de visiteurs différents ont au moins un frais ? » → là, le visiteur 1 apparaît deux fois, le 3 aussi. On ne veut pas les compter deux fois : c'est DISTINCT.
SELECT COUNT(DISTINCT id_visiteur) FROM frais;
COUNT(*) ou COUNT(colonne) ? Le piège des NULL
Deux écritures voisines, mais une différence cruciale :
| Forme | Compte… |
|---|---|
COUNT(*) | toutes les lignes, même celles pleines de cases vides |
COUNT(montant) | seulement les lignes où montant n'est pas NULL (vide) |
Flag B2
Production
Compte le nombre total de visiteurs, puis le nombre de frais de type « Restaurant ». Rends : tes 2 requêtes et leurs résultats.
Flag B2bis
Production
Combien de types de frais différents existent dans la table frais ? (indice : COUNT(DISTINCT …)). Rends : ta requête et son résultat.
2. Totaliser & moyenner
Quatre fonctions essentielles, qui s'appliquent à une colonne de nombres.
| Fonction | Renvoie |
|---|---|
SUM(col) | la somme |
AVG(col) | la moyenne |
MIN(col) | la plus petite valeur |
MAX(col) | la plus grande |
SELECT SUM(montant), AVG(montant), MAX(montant) FROM frais;
Le moins cher et le plus cher : MIN & MAX
SELECT MIN(montant) AS mini, MAX(montant) AS maxi FROM frais;
Arrondir une moyenne : ROUND()
Une moyenne tombe souvent sur un nombre à rallonge (65.48, ou pire 65.4833…). Pour un affichage propre, on l'arrondit avec ROUND.
SELECT ROUND(AVG(montant), 1) AS moyenne FROM frais;
Flag B3
Production
Calcule le total des frais (SUM), le frais moyen arrondi à 2 décimales (ROUND(AVG…, 2)) et le frais le moins cher (MIN), avec des alias clairs. Rends : ta requête et son résultat.
3. Calculer PAR groupe : GROUP BY
Le total de TOUS les frais, c'est bien. Mais on veut souvent le total par visiteur, ou par type. C'est le rôle de GROUP BY : il fait des paquets et calcule sur chacun.
SELECT type, SUM(montant)
FROM frais
GROUP BY type;
Compter par groupe : GROUP BY + COUNT
On peut mettre n'importe quelle fonction d'agrégation après un GROUP BY. « Combien de frais de chaque type ? » → COUNT(*) par groupe.
SELECT type, COUNT(*) AS nb
FROM frais
GROUP BY type;
Flag B4
Production (le total par visiteur)
Affiche, pour chaque id_visiteur, le nombre de frais (COUNT) et leur total (SUM). Rends : ta requête et son résultat (un ligne par visiteur).
4. Filtrer les groupes : HAVING
On a vu WHERE pour filtrer les lignes. Pour filtrer les groupes (après le calcul), c'est HAVING.
SELECT id_visiteur, SUM(montant) AS total
FROM frais
GROUP BY id_visiteur
HAVING SUM(montant) > 100;
Flag B5
Production
Affiche les types de frais dont le total dépasse 100 € (GROUP BY + HAVING). Rends : ta requête et son résultat.
Flag C1
Debug
Cette requête est rejetée par la base :
SELECT type, SUM(montant) FROM frais
WHERE SUM(montant) > 100
GROUP BY type;
Trouve l'erreur, corrige-la pour obtenir les types totalisant plus de 100 €. Rends : la requête corrigée, son résultat, et en une phrase pourquoi l'originale plantait.
5. La requête complète : l'ordre des clauses
Tu connais maintenant cinq clauses. Une vraie requête métier les combine souvent toutes. Mais attention : elles doivent être écrites dans un ordre précis, sinon la base refuse la requête.
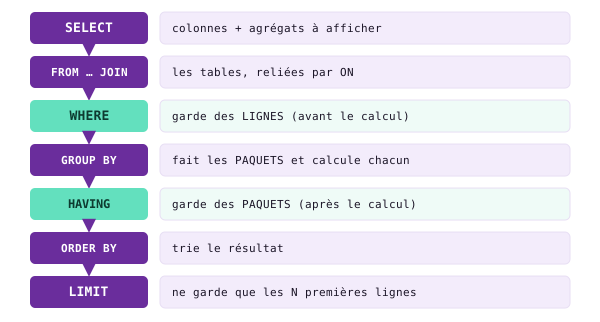
Vert = les deux filtres (WHERE sur les lignes, HAVING sur les paquets). C'est l'ordre dans lequel tu ÉCRIS les clauses.
Un exemple qui empile quatre clauses : « les types de frais (hors Transport) qui totalisent plus de 100 €, du plus gros total au plus petit ».
SELECT type, SUM(montant) AS total
FROM frais
WHERE type <> 'Transport'
GROUP BY type
HAVING SUM(montant) > 100
ORDER BY total DESC;
Flag B5bis
Production (4 clauses)
Affiche, par id_visiteur, le nombre de frais, en ne comptant que les frais d'au moins 20 € (WHERE), en ne gardant que les visiteurs ayant 2 frais ou plus (HAVING COUNT(*) >= 2), triés du plus actif au moins actif. Rends : ta requête et son résultat.
6. Relier deux tables : JOIN
Problème : la table frais ne contient que l'id_visiteur, pas son nom. Pour afficher « Marc a dépensé 120 € », il faut relier les deux tables avec un JOIN, via la clé étrangère.
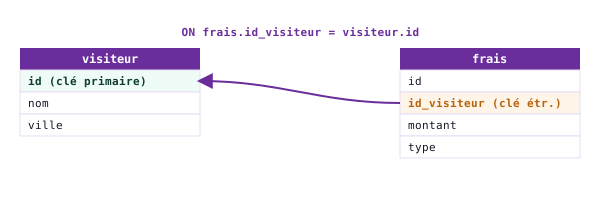
La clé étrangère frais.id_visiteur pointe vers la clé primaire visiteur.id : c'est le pont du JOIN.
SELECT visiteur.nom, frais.montant, frais.type
FROM frais
JOIN visiteur ON frais.id_visiteur = visiteur.id;
Comparatif des types de JOIN
| Type | Ce qu'il garde | Cas d'usage typique |
|---|---|---|
INNER JOIN (= JOIN) | Uniquement les lignes qui ont une correspondance des deux côtés | Tu veux les frais avec le nom du visiteur (chaque frais a forcément un visiteur) |
LEFT JOIN | Toute la table de gauche + correspondances à droite (NULL si aucune) | Tu veux TOUS les visiteurs, même ceux sans frais (Léa = NULL) |
RIGHT JOIN | Toute la table de droite + correspondances à gauche (NULL si aucune) | Rare en pratique — on réécrit presque toujours en LEFT JOIN en inversant l'ordre des tables |
FULL OUTER JOIN | Toutes les lignes des deux côtés, NULL là où il n'y a pas de correspondance | Comparaison de deux ensembles indépendants. Non supporté en MySQL — simuler avec LEFT JOIN + UNION + RIGHT JOIN |
Alléger avec des alias de table
Écrire frais. et visiteur. partout, c'est long. On donne à chaque table un surnom (alias) juste après son nom dans le FROM : frais f, visiteur v.
SELECT v.nom, f.montant, f.type
FROM frais f
JOIN visiteur v ON f.id_visiteur = v.id;
Filtrer sur une colonne de l'autre table
Une fois les tables reliées, le WHERE peut porter sur n'importe quelle colonne des deux tables. Exemple : « tous les frais des visiteurs basés à Lyon ». La ville est dans visiteur, le montant dans frais : sans JOIN, impossible.
SELECT v.nom, f.montant, f.type
FROM frais f
JOIN visiteur v ON f.id_visiteur = v.id
WHERE v.ville = 'Lyon';
Flag B6
Production (JOIN + agrégat)
Affiche, pour chaque nom de visiteur, le total de ses frais (JOIN entre frais et visiteur + GROUP BY sur le nom). Utilise des alias f et v. Rends : ta requête et son résultat.
7. Grouper sur plusieurs colonnes
On peut faire des paquets sur deux colonnes à la fois : un paquet par combinaison. Exemple métier : « combien dépense-t-on par ville ET par type de frais ? » La ville est dans visiteur, le type dans frais → on a besoin du JOIN.
SELECT v.ville, f.type, COUNT(*) AS nb, SUM(f.montant) AS total
FROM frais f
JOIN visiteur v ON f.id_visiteur = v.id
GROUP BY v.ville, f.type
ORDER BY v.ville, total DESC;
Flag B7
Production
Affiche le nombre de frais par ville (une seule colonne de regroupement : v.ville), trié de la ville la plus dépensière à la moins dépensière. Rends : ta requête et son résultat.
8. INNER JOIN vs LEFT JOIN
Le JOIN qu'on a utilisé jusqu'ici est un INNER JOIN (jointure interne) : il ne garde que les lignes qui ont une correspondance des deux côtés. Conséquence : un visiteur sans aucun frais n'apparaîtrait pas. Souvent on veut quand même le voir (avec un total de 0). C'est le LEFT JOIN.
Étape 1 — On ajoute un visiteur sans frais
INSERT INTO visiteur VALUES (4, 'Léa', 'Nice');
Étape 2 — L'INNER JOIN l'ignore
SELECT v.nom, f.montant
FROM visiteur v
JOIN frais f ON f.id_visiteur = v.id
ORDER BY v.id;
Étape 3 — Le LEFT JOIN la garde
SELECT v.nom, f.montant
FROM visiteur v
LEFT JOIN frais f ON f.id_visiteur = v.id
ORDER BY v.id;
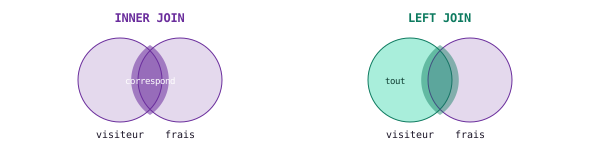
INNER JOIN = seulement l'intersection (qui correspond des deux côtés). LEFT JOIN = TOUTE la table de gauche + ce qui correspond à droite.
Étape 4 — Le piège des NULL avec COUNT
Maintenant qu'on a des NULL, la différence COUNT(*) vs COUNT(colonne) devient visible :
SELECT COUNT(*) AS lignes, COUNT(f.montant) AS frais_reels
FROM visiteur v
LEFT JOIN frais f ON f.id_visiteur = v.id;
Étape 5 — Le total par visiteur, Léa comprise
SELECT v.nom, COUNT(f.id) AS nb_frais, SUM(f.montant) AS total
FROM visiteur v
LEFT JOIN frais f ON f.id_visiteur = v.id
GROUP BY v.nom
ORDER BY total DESC;
Flag B8
Production (avant de nettoyer)
Pendant que Léa est encore là : écris la requête LEFT JOIN qui affiche chaque nom et son nombre de frais (COUNT(f.id)), Léa incluse avec 0. Rends : ta requête et son résultat (4 lignes).
9. Mini-projet : le tableau de bord GSB
On produit de vraies statistiques métier, comme un développeur le ferait sur la base de GLPI/GSB. Vérifie d'abord que tu as bien supprimé Léa (3 visiteurs).
Les questions à traduire en SQL
- Combien de frais au total ? (COUNT)
- Quel est le montant total et moyen (arrondi à 2 décimales) des frais ? (SUM, ROUND, AVG)
- Le total des frais par type, du plus gros au plus petit. (GROUP BY + ORDER BY)
- Les visiteurs (par nom) ayant dépensé plus de 100 € au total. (JOIN + GROUP BY + HAVING)
- Le nom du visiteur ayant le frais le plus élevé. (JOIN + ORDER BY + LIMIT)
Flag B9
Mini-projet (production)
Écris les 5 requêtes et exécute-les. Rends : tes 5 requêtes et leurs résultats. C'est exactement le type de statistiques que tu sortiras de la base GLPI dans le projet AP.
10. Entraînement express
Le SQL ne s'apprend qu'en écrivant des requêtes. Voici une batterie de petits défis : pour chacun, écris la requête, exécute-la, et garde le résultat. Tout se résout avec ce que tu viens d'apprendre (base de 3 visiteurs, 5 frais — Léa supprimée).
Flag B10
Série « agrégats »
Écris une requête pour chaque question (4 requêtes + résultats) :
a) Le nombre de frais qui dépassent 50 €.
b) Le montant moyen des frais de type « Hotel », arrondi à 2 décimales.
c) Le frais le plus cher ET le moins cher en une seule requête.
d) Le nombre de villes différentes dans la table visiteur.
Flag B11
Série « groupes »
Écris une requête pour chaque question (3 requêtes + résultats) :
a) Le nombre de frais par type.
b) Le total des frais par id_visiteur, trié du plus gros total au plus petit.
c) Les types dont la moyenne de frais dépasse 50 € (GROUP BY + AVG + HAVING).
Flag B12
Série « jointures »
Écris une requête pour chaque question (3 requêtes + résultats), avec des alias f / v :
a) Le nom du visiteur en face de chaque frais (nom + montant + type).
b) Pour chaque ville, le total dépensé par les visiteurs de cette ville (JOIN + GROUP BY).
c) Le nom du visiteur qui a fait le frais le plus cher (JOIN + ORDER BY + LIMIT 1).
Flag D1
Investigation
Dans la doc SQL (ou sur sqliteonline), cherche la différence entre ORDER BY total ASC et ORDER BY total DESC. Rends : en une phrase, ce que fait ASC et ce que fait DESC, et lequel est appliqué par défaut si tu n'écris ni l'un ni l'autre.
Flag E1
Extension qualité
Reprends la requête « total par visiteur ». Améliore-la pour qu'elle affiche le nom du visiteur (pas son id), son nombre de frais et son total arrondi, le tout trié du plus gros dépensier au plus petit, avec des alias de colonnes lisibles. Rends : ta requête et son résultat.
Pour finir
Ton antisèche
| Je veux… | SQL |
|---|---|
| compter | COUNT(*) |
| compter sans doublons | COUNT(DISTINCT col) |
| totaliser / moyenner | SUM(col) / AVG(col) |
| min / max | MIN(col) / MAX(col) |
| arrondir | ROUND(col, n) |
| calculer par groupe | GROUP BY col (ou col1, col2) |
| filtrer des groupes | HAVING agrégat … |
| relier 2 tables | JOIN t2 ON t1.fk = t2.id |
| garder aussi les « sans correspondance » | LEFT JOIN t2 ON … |
| l'ordre des clauses | SELECT · FROM/JOIN · WHERE · GROUP BY · HAVING · ORDER BY · LIMIT |
Vérifie tes acquis
- Que fait
COUNT(*)? - Différence entre
SUMetAVG? - À quoi sert
GROUP BY? - Différence entre
WHEREetHAVING? - À quoi sert un
JOINet la clauseON? - Pourquoi le JOIN justifie-t-il qu'on découpe les données en plusieurs tables ?
- Différence entre
COUNT(*)etCOUNT(montant)quand il y a des NULL ? - Quand préfère-t-on
LEFT JOINà unJOINclassique ? - Dans quel ordre écrit-on WHERE, GROUP BY, HAVING et ORDER BY ?
Corrigé du quiz
| # | Question | Réponse |
|---|---|---|
| 1 | COUNT(*) ? | Compte le nombre total de lignes du résultat, NULL ou pas. |
| 2 | SUM vs AVG ? | SUM additionne toutes les valeurs ; AVG divise la somme par le nombre de valeurs non NULL. AVG = SUM / COUNT(colonne). |
| 3 | GROUP BY ? | Regroupe les lignes en paquets selon une ou plusieurs colonnes, et applique une fonction d'agrégation (SUM, COUNT…) à chaque paquet. |
| 4 | WHERE vs HAVING ? | WHERE filtre des lignes avant le calcul (peut utiliser un index). HAVING filtre des groupes après le calcul. On ne peut pas mettre un agrégat (SUM(…) > 100) dans un WHERE. |
| 5 | JOIN et ON ? | JOIN relie deux tables. ON donne la condition de liaison (clé étrangère = clé primaire). Sans ON → produit cartésien (chaque ligne × chaque ligne). |
| 6 | Pourquoi plusieurs tables ? | On stocke chaque info une seule fois (le nom du visiteur dans visiteur) et on recompose à la demande avec JOIN. Évite la redondance, les incohérences et facilite la maintenance. |
| 7 | COUNT(*) vs COUNT(montant) avec NULL ? | COUNT(*) compte toutes les lignes, y compris celles avec NULL. COUNT(montant) ignore les lignes où montant est NULL. |
| 8 | Quand LEFT JOIN ? | Quand on veut garder toutes les lignes de la table de gauche, même sans correspondance à droite (les colonnes de droite valent alors NULL). Ex. : liste de tous les visiteurs, même ceux sans frais. |
| 9 | Ordre des clauses ? | SELECT → FROM/JOIN → WHERE → GROUP BY → HAVING → ORDER BY → LIMIT. |
Glossaire
| Mot | Définition |
|---|---|
| Agrégation | un calcul sur plusieurs lignes (COUNT, SUM, AVG, MIN, MAX) qui réduit N lignes à 1 valeur |
| COUNT(*) | compte toutes les lignes, y compris celles avec des NULL |
| COUNT(col) | compte les lignes où col n'est pas NULL (ignore les cases vides) |
| DISTINCT | ne garde qu'une fois chaque valeur (supprime les doublons) ; utile dans COUNT(DISTINCT col) |
| NULL | case vide, absence de valeur (≠ 0, ≠ chaîne vide) ; ignorée par COUNT(colonne) et SUM(colonne) |
| COALESCE(a, b) | renvoie a si non NULL, sinon b. Standard SQL. Remplace un NULL par une valeur par défaut (ex. 0) |
| SUM / AVG | somme / moyenne d'une colonne (ignorent les NULL) |
| DECIMAL(p,s) | nombre exact à p chiffres significatifs dont s après la virgule. Utiliser pour les montants (jamais FLOAT) |
| ROUND(x, n) | arrondit x à n décimales |
| GROUP BY | regroupe les lignes pour calculer par groupe (1 ou plusieurs colonnes) |
| HAVING | filtre les groupes après agrégation (≠ WHERE qui filtre les lignes avant) |
| Produit cartésien | résultat d'un JOIN sans clause ON : chaque ligne de la table gauche combinée avec chaque ligne à droite → N × M lignes fausses |
| Alias de table | surnom court d'une table (frais f) pour alléger l'écriture dans SELECT / ON / WHERE |
| INNER JOIN (= JOIN) | relie deux tables ; ne garde que les lignes qui correspondent des deux côtés |
| LEFT JOIN | garde TOUTE la table de gauche, même sans correspondance à droite (colonnes de droite = NULL) |
| ON | condition de liaison d'un JOIN : clé étrangère (côté N) = clé primaire (côté 1) |
| FOREIGN KEY | contrainte qui interdit d'insérer un id_visiteur qui n'existe pas dans visiteur.id |
| LIMIT | ne garde que les N premières lignes du résultat (toujours après ORDER BY) |